
Vibe coding: waarom je uiteindelijk meer aan het debuggen bent dan aan het bouwen
Vibe coding klinkt aantrekkelijk. Je beschrijft wat je wilt bouwen, een AI-model schrijft de code en binnen enkele minuten heb je een werkende applicatie. Je hoeft geen programmeur te zijn, want de AI regelt het technische gedeelte.
Tenminste, dat is het idee. In de praktijk ontdek je al snel dat code genereren iets heel anders is dan betrouwbare software ontwikkelen. Zeker wanneer je zelf niet begrijpt wat de gegenereerde code doet.
Kort antwoord: vibe coding versnelt het schrijven van code, maar niet automatisch het testen, beveiligen en onderhouden van software. Zonder technische controle kan de tijdwinst bij het bouwen omslaan in extra debugwerk.
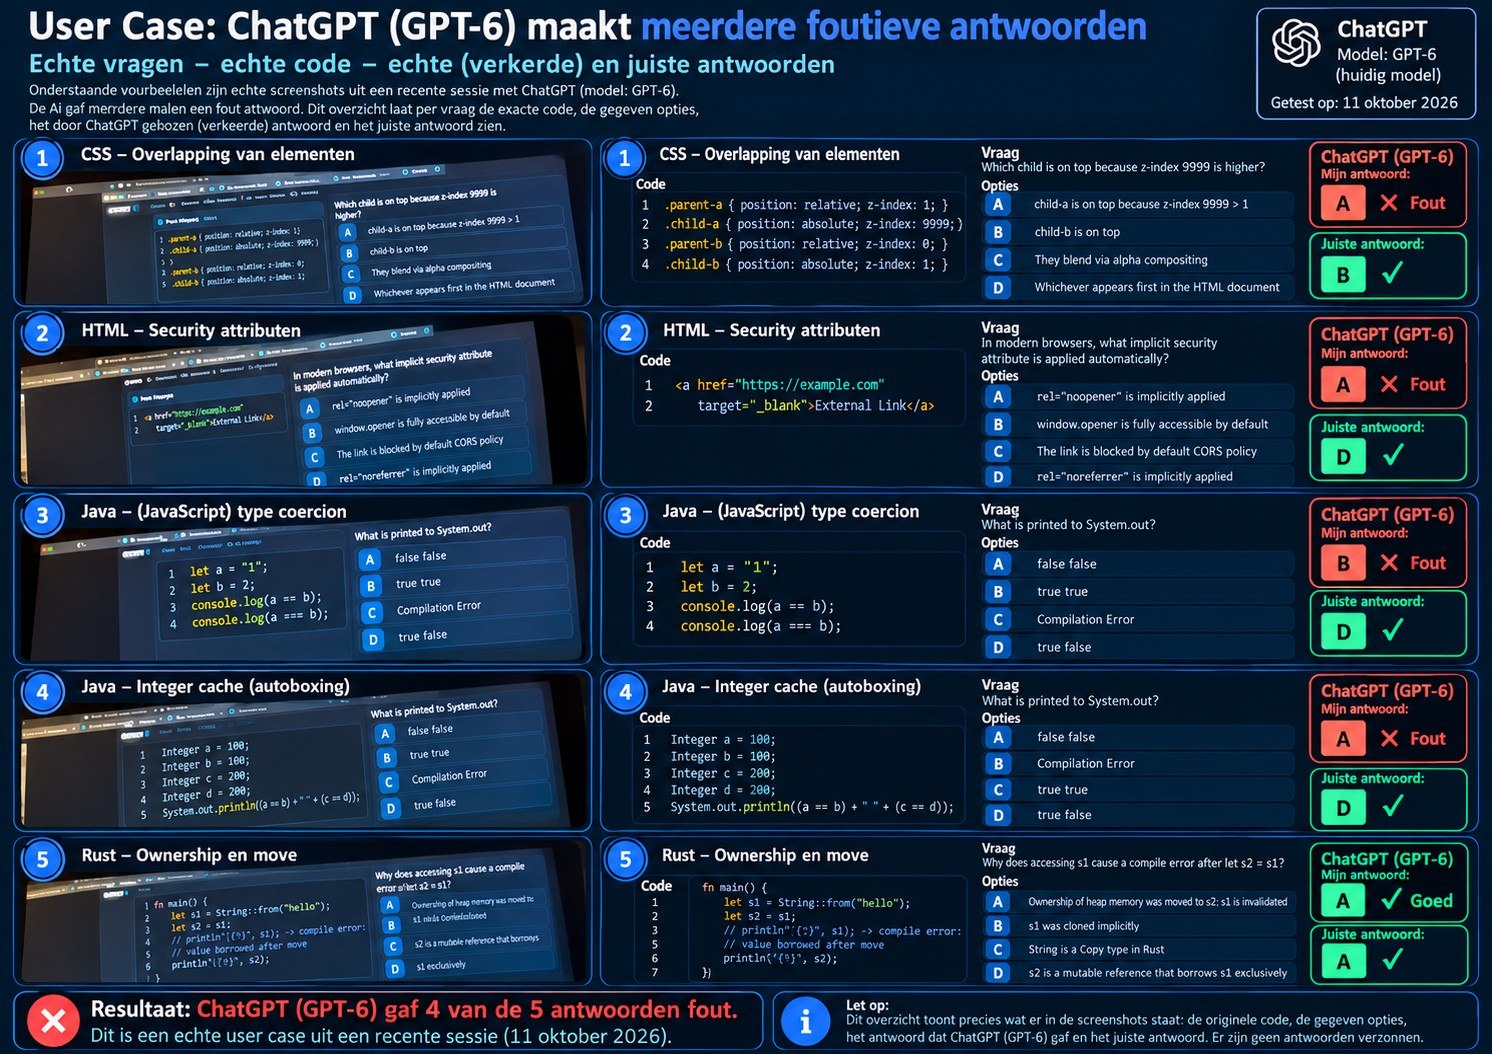
Een praktijkvoorbeeld: ChatGPT GPT-6 en vijf programmeervragen
Op 11 oktober 2026 testte ik ChatGPT GPT-6 met vijf programmeervragen uit een code-predictiongame. Bij deze vragen krijg je een stukje code te zien en moet je voorspellen wat er gebeurt wanneer die code wordt uitgevoerd.
Dat lijkt eenvoudig. Je hoeft immers geen complete applicatie te bouwen. Je hoeft alleen te begrijpen wat een paar regels code doen. Toch ging het meerdere keren mis.
De test leverde het volgende resultaat op:
| Onderwerp | Antwoord ChatGPT | Juiste antwoord volgens de quiz | Beoordeling |
|---|---|---|---|
| JavaScript: array inkorten | C | A | Fout |
| CSS: stacking contexts en z-index | A | B | Fout |
| HTML: beveiliging van externe links | A | B | Fout |
| Java: Integer-cache | A | D | Fout |
| Rust: ownership en move | A | A | Goed |
Het resultaat: vier van de vijf antwoorden waren fout. Alleen de vijfde vraag, over Rust, werd correct beantwoord. Dat is een opvallende uitkomst voor een AI-model dat ook wordt gebruikt om programmeercode te schrijven, analyseren en corrigeren.
Belangrijke kanttekening: getest met ChatGPT Plus, niet met Pro
Deze test is uitgevoerd met GPT-6 via een betaald ChatGPT Plus-abonnement. De vier verkeerde antwoorden zijn dus afkomstig uit een sessie met ChatGPT Plus. Er is geen vergelijkbare test uitgevoerd met een ChatGPT Pro-abonnement.
Ik kan daarom niet vaststellen of GPT-6 met een Pro-abonnement dezelfde fouten zou hebben gemaakt. Evenmin kan ik op basis van deze test concluderen dat Pro betere of slechtere antwoorden zou geven. De resultaten gelden uitsluitend voor de onderzochte testsessie en mogen niet worden gepresenteerd als een vergelijking tussen ChatGPT Plus en Pro.
Fout 1: een eenvoudige JavaScript-array
const arr = ['a', 'b', 'c', 'd'];
arr.length = 2;
console.log(arr);
ChatGPT koos voor een TypeError. In werkelijkheid wordt de array ingekort tot twee elementen:
['a', 'b']Dit is standaardgedrag van JavaScript. Door de length-property te verkleinen, verdwijnen de elementen buiten de nieuwe lengte. Een AI-model dat dit verkeerd beoordeelt, kan ook tijdens het ontwikkelen van een applicatie een verkeerde diagnose stellen over arraymanipulatie.
Fout 2: CSS en stacking contexts
De tweede vraag ging over twee overlappende elementen met verschillende z-index-waarden. Een van de elementen had een z-index van 9999. Het andere had een veel lagere waarde. ChatGPT koos het element met de hoogste z-index.
Maar dat was niet het juiste antwoord. In CSS worden elementen niet uitsluitend gerangschikt op basis van hun individuele z-index. De stacking context van het bovenliggende element speelt eveneens een rol.
Een element met z-index: 9999 kan daardoor achter een element met z-index: 1 verschijnen wanneer beide elementen zich in verschillende stacking contexts bevinden. Dit soort fouten is herkenbaar voor iedereen die ooit een dropdownmenu, modal of navigatiemenu heeft proberen te repareren.
De AI ziet een hoge z-index en concludeert dat het element bovenaan hoort te staan. Maar zonder de volledige stacking-contextstructuur te begrijpen, kan die conclusie verkeerd zijn.
Fout 3: HTML-beveiliging
De derde vraag ging over de beveiliging van externe links. De code was:
<a href="https://example.com" target="_blank">
  External Link
</a>
De vraag was welk beveiligingsattribuut moderne browsers impliciet toepassen. ChatGPT koos antwoord A, terwijl de quiz antwoord B als correct beoordeelde.
Dit soort vragen laat zien hoe belangrijk het is om beveiligingsmechanismen in webapplicaties goed te begrijpen. Een kleine wijziging in een HTML-attribuut kan gevolgen hebben voor de manier waarop een browser met externe pagina’s omgaat.
Verificatiebeperking: de actuele live spelcode die tijdens deze controle is bekeken, markeert rel="noopener" als het juiste antwoord (optie A) en legt uit dat moderne browsers dit bij target="_blank" impliciet toepassen. De oorspronkelijke spelversie en antwoordopties van 11 oktober 2026 zijn niet als historische snapshot beschikbaar. Daarom kan de letterbeoordeling uit de oorspronkelijke test niet onafhankelijk worden gereconstrueerd; het spelresultaat en de technische juistheid moeten hier als afzonderlijke zaken worden gelezen.
Fout 4: Java en de Integer-cache
Integer a = 100;
Integer b = 100;
Integer c = 200;
Integer d = 200;
System.out.println((a == b) + " " + (c == d));
ChatGPT koos antwoord A. Het juiste antwoord volgens de quiz was D: true false.
Java gebruikt bij autoboxing een cache voor bepaalde Integer-waarden, waaronder de waarden van -128 tot en met 127. Daardoor verwijzen a en b naar hetzelfde gecachte object. De waarde 200 valt buiten het verplichte cachebereik. In deze context levert dat verschillende objectreferenties op voor c en d.
Omdat == bij deze objecten referenties vergelijkt, ontstaat het resultaat true false. Dit is een voorbeeld van hoe een klein verschil in de werking van een programmeertaal grote gevolgen kan hebben voor de uitkomst.
De vijfde vraag: Rust ging wél goed
fn main() {
    let s1 = String::from("hello");
    let s2 = s1;
    println!("{}", s2);
}
De vraag was waarom het opnieuw gebruiken van s1 na let s2 = s1 een compileerfout zou veroorzaken. ChatGPT koos het juiste antwoord: het ownership van de String wordt verplaatst naar s2, waardoor s1 niet langer geldig is.
De quiz bevestigde dit antwoord als correct. Ook dat hoort bij een eerlijke beoordeling. Een AI-model kan fouten maken, maar dat betekent niet dat ieder antwoord fout is.
Waarom vibe coding vaak verandert in debuggen
Het aantrekkelijke van vibe coding is de snelheid waarmee je iets kunt maken. Een dashboard, webshop, automatisering of zelfs een complete webapplicatie kan in korte tijd worden gegenereerd. Maar daarna begint het echte werk.
Een knop reageert niet. Een database slaat gegevens verkeerd op. Een gebruiker kan een pagina openen waarvoor die geen toegang hoort te hebben. Een update veroorzaakt een regressie. Of een functie werkt tijdens een demonstratie, maar niet wanneer echte gebruikers ermee aan de slag gaan.
Je vraagt de AI om het probleem op te lossen. De AI verandert de code. Het oorspronkelijke probleem verdwijnt, maar ergens anders ontstaat een nieuw probleem. Vervolgens vraag je opnieuw om een oplossing. Zo verandert vibe coding langzaam in een eindeloze debugcyclus.
Het probleem is niet dat AI geen bruikbare code kan schrijven. Het probleem ontstaat wanneer niemand meer begrijpt waarom die code werkt, welke aannames erin zitten en welke onderdelen door een wijziging worden beïnvloed.
Zonder programmeerkennis kun je de oplossing niet goed beoordelen
Stel dat je een applicatie bouwt waarin gebruikers kunnen inloggen, persoonlijke gegevens kunnen opslaan en betalingen kunnen uitvoeren. AI kan helpen bij de interface, authenticatie, databasekoppelingen en betaalintegratie.
Maar hoe controleer je vervolgens of:
- gebruikers uitsluitend toegang hebben tot hun eigen gegevens;
- databasebewerkingen correct worden afgehandeld;
- gevoelige gegevens veilig worden verwerkt;
- fouten niet ongemerkt worden genegeerd;
- een nieuwe wijziging bestaande functionaliteit niet beschadigt?
Als je geen kennis hebt van programmeren, softwarearchitectuur en beveiliging, kun je moeilijk beoordelen of de voorgestelde oplossing daadwerkelijk correct is. Een applicatie die er goed uitziet, is nog geen betrouwbare applicatie. En een AI-model dat zegt dat een probleem is opgelost, levert daarmee nog geen bewijs dat het probleem daadwerkelijk is opgelost.
Het gevaar van schijnzekerheid
Wat tijdens mijn test vooral opviel, was hoe gemakkelijk een kort en stellig antwoord verkeerd kan zijn. Bij de JavaScript-vraag gaf ChatGPT simpelweg de letter C. Bij de CSS-vraag volgde A. Beide antwoorden waren fout.
Er werd geen onzekerheid aangegeven en er vond geen zichtbare uitvoering van de code plaats om het antwoord te controleren. Dat is een belangrijk onderscheid. AI kan overtuigend formuleren zonder dat de uitkomst correct is.
Bij softwareontwikkeling kan die schijnzekerheid leiden tot technische schulden: code die aanvankelijk functioneert, maar steeds moeilijker te onderhouden en te corrigeren wordt. Hoe groter de applicatie, hoe meer afhankelijkheden er ontstaan. Een wijziging in één component kan gevolgen hebben voor andere onderdelen van het systeem. Zonder inzicht in die afhankelijkheden wordt iedere nieuwe AI-aanpassing een extra risico.
Ook AI-verificatie moet je controleren
Wanneer een AI-model code schrijft en een ander AI-model die code beoordeelt, kunnen beide dezelfde verkeerde aannames gebruiken. Daarom moet verificatie verder gaan dan de mededeling dat iets is geslaagd of mislukt.
Een goede controle kijkt naar het daadwerkelijke gedrag van de software, de relevante technische specificaties en de gevolgen voor bestaande functionaliteit. Tests zijn belangrijk, maar alleen wanneer ze meten wat ze daadwerkelijk moeten meten.
AI is een hulpmiddel, geen vervanging voor technische kennis
Dat betekent niet dat vibe coding waardeloos is. Integendeel. AI kan enorm helpen bij het schrijven van boilerplate, het ontwikkelen van prototypes, het analyseren van foutmeldingen, het opzetten van tests en het versnellen van repetitieve programmeertaken.
Maar er is een wezenlijk verschil tussen AI gebruiken om sneller te programmeren en AI gebruiken omdat je zelf niet kunt programmeren. In het eerste geval kun je de gegenereerde code beoordelen, aanpassen en testen. In het tweede geval ben je grotendeels afhankelijk van de juistheid van het AI-model.
En zoals deze programmeerquiz laat zien, mag je die juistheid niet zomaar aannemen. Een verstandige werkwijze is daarom om AI-gegenereerde code te controleren met automatische tests, onafhankelijke verificatie en waar nodig een menselijke code review. Vooral bij authenticatie, betalingen, persoonsgegevens en andere kritieke functionaliteit.
Conclusie: vibe coding is niet hetzelfde als softwareontwikkeling
Vibe coding maakt het eenvoudiger om te beginnen met bouwen. Dat is een echte vooruitgang. Maar de drempel om code te genereren is niet dezelfde als de drempel om goede software te ontwikkelen.
Je kunt zonder programmeerkennis een indrukwekkend prototype maken. Dat betekent nog niet dat je zelfstandig een veilige, schaalbare en onderhoudbare applicatie kunt opleveren. Daarvoor moet je begrijpen wat de code doet, waarom bepaalde keuzes worden gemaakt en hoe je fouten systematisch onderzoekt.
Anders bestaat het risico dat je uiteindelijk meer tijd besteedt aan het herstellen van AI-gegenereerde problemen dan aan het ontwikkelen van nieuwe functionaliteit.
Vibe coding versnelt het schrijven van code. Het neemt de verantwoordelijkheid voor de werking ervan niet weg.
Deze praktijkcase is gebaseerd op vijf programmeervragen die op 11 oktober 2026 aan ChatGPT GPT-6 zijn voorgelegd via een ChatGPT Plus-abonnement. Vier antwoorden werden door de quiz als fout beoordeeld en één antwoord was correct. De uitkomst betreft deze specifieke testsessie en is geen algemene benchmark van GPT-6 of een vergelijking met ChatGPT Pro.
Zelf controleren?
De test is uitgevoerd met ChatGPT via een betaald Plus-abonnement. De originele ChatGPT-conversatie kan worden opgevraagd bij de auteur. Daarin zijn de gestelde vragen en de antwoorden van het model terug te vinden, zodat je de test zelf kunt beoordelen zonder uitsluitend op deze analyse af te gaan.
Onderzoeksmethode en bronvermelding
Op 11 oktober 2026 heb ik ChatGPT GPT-6 getest met vijf programmeervragen uit Output – Code Predict, mijn online codespel.
De vragen zijn afkomstig uit de spelomgeving: Output – Code Predict. De antwoorden zijn gegeven door GPT-6 tijdens een sessie met een betaald ChatGPT Plus-abonnement. Van de vijf antwoorden werden er vier door het spel als fout beoordeeld en één als correct.
Ik ben zelf de uitvoerder en primaire bron van deze test. De originele ChatGPT-conversatie is bewaard en kan op verzoek worden ingezien.
De actuele spelbron is tijdens deze controle afzonderlijk geraadpleegd. Dat bevestigt de huidige vraaginhoud en technische uitleg, maar bewijst niet automatisch welke antwoordopties of beoordeling op 11 oktober 2026 zichtbaar waren.
Er is geen vergelijkbare test uitgevoerd met ChatGPT Pro. Daarom kan ik niet vaststellen of dezelfde fouten met dat abonnement zouden zijn gemaakt.
Redactionele verantwoording
Dit artikel is met behulp van ChatGPT GPT-6 geschreven en gestructureerd, op basis van mijn eigen testsessie en bevindingen.
Zelf de resultaten beoordelen?
Speel Output – Code Predict of vraag via de contactpagina de originele ChatGPT-conversatie op.
